为大规模训练与推理任务提供可靠的 GPU 计算能力
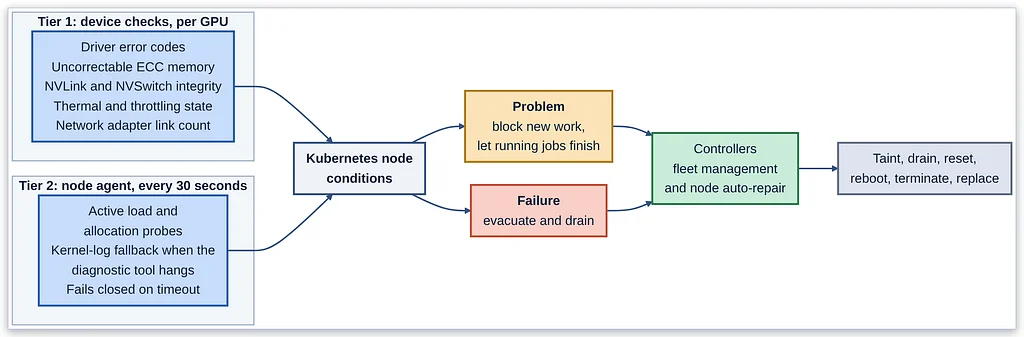
Netflix 严重依赖 GPU 进行个性化内容推荐及其他机器学习应用。这些 GPU 对于内容训练和提供服务至关重要,其可靠性既是保障可用性的商业必需,也是实现成本效率的关键。基础云提供商的健康检查不足,因为它们无法检测可能导致长时间运行训练任务瘫痪的细微 GPU 或网络 fabric 故障。此类故障可能表现为性能缓慢或任务完全停止,从而影响用户体验并造成资源浪费。Netflix 采用分层方法以确保 GPU 基础设施的健康。第一层专注于检测并修复故障硬件,如 GPU 和网络适配器。第二层涉及调度器和平台,在任务重试之前验证机器。第三层使长时间运行的任务能够通过检查点和弹性工作节点在机器丢失时继续运行。第四层是可观测性,用于监控前三层的有效性。健康检查分为两个层级:针对单个 GPU 的设备级检查,以及由代理执行的节点级检查。这些检查将结果报告为 Kubernetes 节点条件。当检测到问题时,会更新机器的状态,并由控制器采取行动。初始问题会被容忍,但持续性故障会升级为机器疏散、资源排空和替换。修复措施是分级的,根据故障严重程度匹配相应操作,范围从重启单个 GPU 到终止并替换整个机器。对于持续故障的硬件,会记录不可变标识符以防止其重新加入资源池。机器在释放用于工作前会经过验证,确保通过所有诊断。最后,通过检查点使长时间运行的任务具备弹性,允许在机器丢失时从最后一个稳定状态恢复。