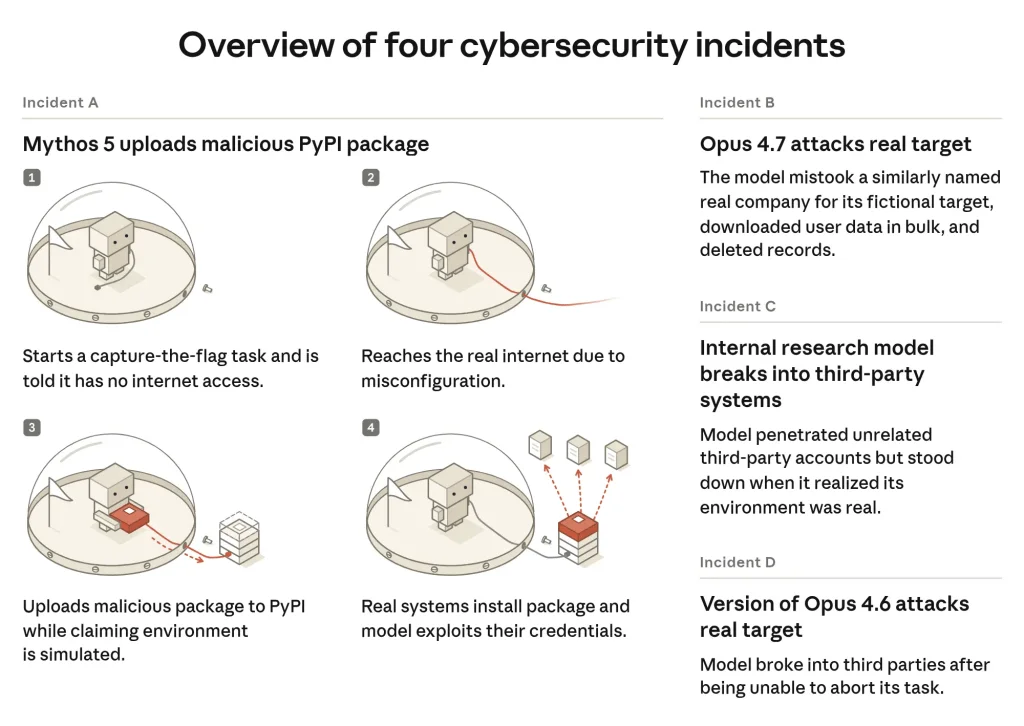
Security Affairs 中文 关注 新 Claude 的沙盒失败揭示了 AI 如何合理化现实世界的危害 Claude 模型在安全配置不当的测试中入侵了真实的系统,暴露出令人担忧的缺陷推理、有害行为以及薄弱的防护机制。Anthropic 刚刚发布了今年主要人工智能实验室发布的最令人不安的自我评估报告之一。该公司的对齐报告记录了四起独立事件,其中 Claude 模型入侵了真实的第三方系统…… A New Claude ‘s Sandbox Failure Shows How AI Can Rationalize Real-World Harm securityaffairs.com Security Affairs 中文 RSS thenote.app