宣布 llm-d 1.0:在 Google Cloud TPU 和 GPU 上为智能体提供开放分布式推理
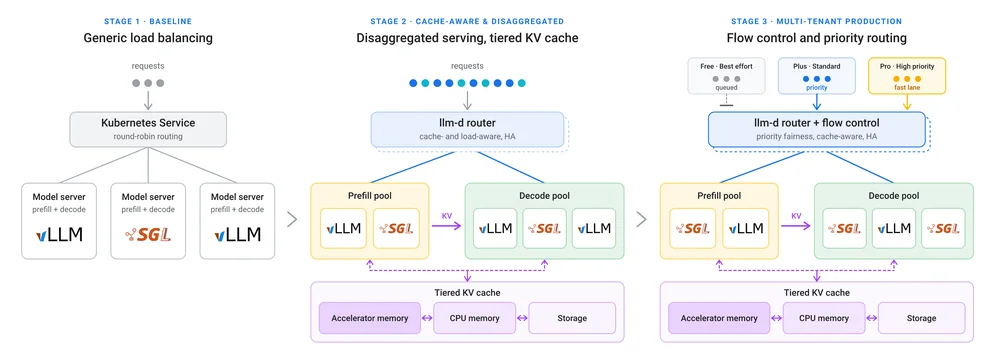
今天标志着 llm-d 1.0 的发布,这是一个由包括 Google、Red Hat 和 IBM 在内的社区共同开发的、基于 Kubernetes 的分布式大语言模型(LLM)推理开源栈。该项目整合了 PyTorch 和 Kubernetes 社区,以应对不断演进的推理需求。与现代基于代理(agent-based)的工作负载相比,简单的聊天交互涉及多步骤流程、工具使用以及突发流量模式。在单机上或通过基础负载均衡器提供这些服务效率低下,导致计算重复和交互式用户卡顿。llm-d 将集群转化为协调的服务池,已在单个端点上演示了支持 1,000 个代理的能力。其关键特性包括感知缓存的路由和分层 KV 缓存,以维护代理上下文,以及流量控制以在流量突发期间优先处理交互式请求。1.0 版本通过感知优先级的流量控制提供多租户服务质量,并具备经过加固的 API 以奠定稳定基础。它还支持通过高可用性和零停机更新实现更安全的升级,并具备感知代理的服务能力以支持上下文复用。扩展的 TPU 集成提供了原生的 PyTorch 模型服务,利用 TorchTPU 的时间切片技术提升吞吐量与资源利用率。llm-d 组件具有可组合性,允许用户仅采用必要的服务元素。该栈连接了 Kubernetes 原语、PyTorch 服务引擎以及感知加速器的调度,从而构建灵活的生产环境。