用于 AI 推理模型服务的网络——仅限 GKE 及其他所有后端
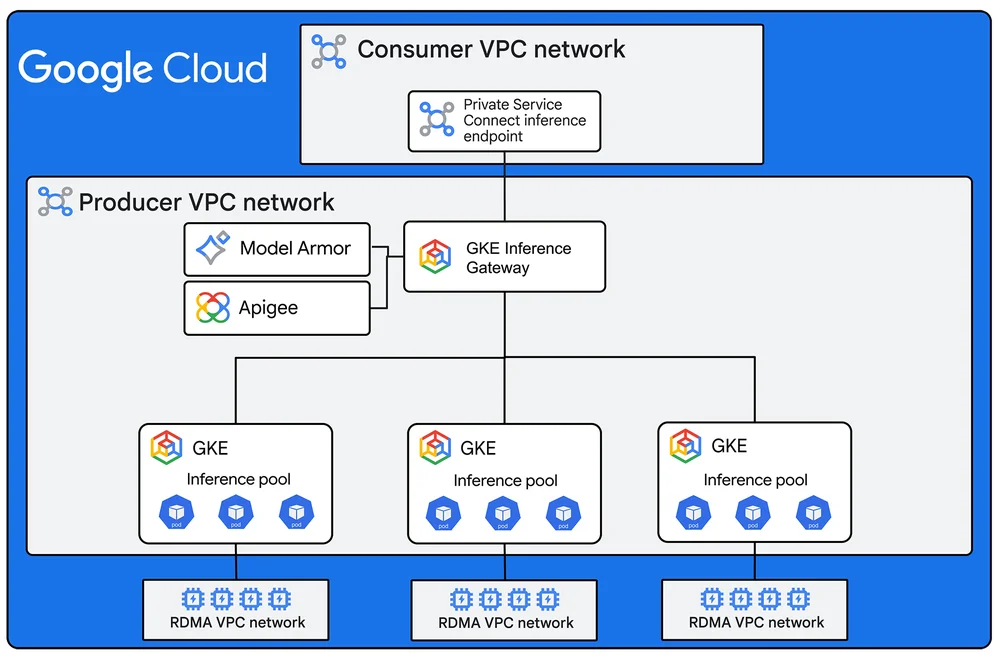
企业通常运行多个 AI 推理模型,因此需要支持简化调用和集中治理的架构。本文介绍了两种用于 AI 推理模型服务的网络参考架构:一种适用于 Google Kubernetes Engine (GKE),另一种适用于其他所有后端类型。这两种架构均包含用于增强安全性和效率的通用服务。入口点(无论是 Cloud Load Balancer 还是 Inference Gateway)为推理调用提供稳定且安全的前端。该入口点负责 TLS 终止,集成 API 管理功能,并可通过服务扩展扩展功能。两种设计中的通用服务包括:Private Service Connect 推理端点,用于将入口点锚定在消费者 VPC 网络中;Apigee API Management 为可选服务,用于客户端身份验证、速率限制和配额执行;Model Armor 作为内联 AI 安全检查点,对提示词和输出进行筛选。针对 GKE 的专用设计使用 GKE Inference Gateway,作为专用入口引擎。该网关根据 HTTPRoute 规则将查询路由至相应的模型服务目标。推理池(Inference pools)是模型副本的逻辑分组,网关根据模型标识符选择正确的池。模型副本集(Model replica sets)代表部署在各个节点池中的统一模型副本组。对于服务多种后端类型的架构,区域内部应用负载均衡器(Application Load Balancer)作为中央路由代理。Inference Payload Processor 作为服务扩展实现,用于检查传入的请求负载以提取目标模型标识符。网络端点组(NEGs)根据该标识符提供对异构后端的灵活路由。