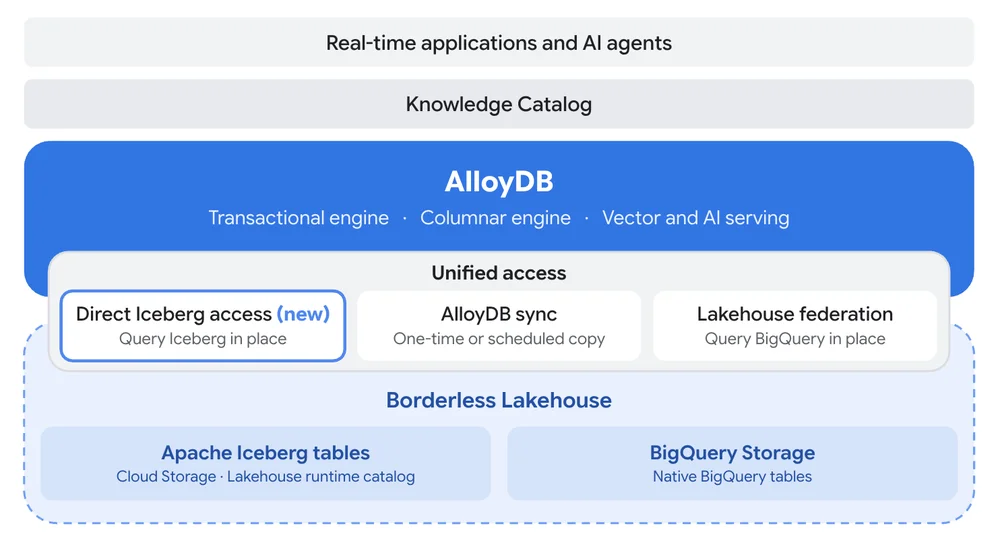
在 AlloyDB for PostgreSQL 中通过直接访问 Iceberg 统一操作数据与 Lakehouse 数据
企业需要实时运营数据和历史分析数据以支持有效决策。传统上彼此分离的数据系统如今正趋于融合,AlloyDB for PostgreSQL 的新功能便是例证。Google Cloud 现已推出直接访问 Iceberg 的功能,允许开发人员直接从 AlloyDB 查询云存储中的 Apache Iceberg 表,并通过单条 SQL 查询将其与实时数据关联。此项集成目前处于预览阶段,在聚合查询方面显著快于其他服务。此外,AlloyDB Sync 和 Lakehouse 联邦现已普遍可用,提供了三种与“无边界 Lakehouse"交互的主要方式。直接 Iceberg 访问就地读取 Iceberg 表,利用 AlloyDB 的列式引擎实现加速。AlloyDB Sync 将 Lakehouse 数据从 BigQuery 复制到 AlloyDB,适用于低延迟、频繁访问的工作负载,并按用户定义的 schedule 进行刷新。Lakehouse 联邦使 AlloyDB 能够直接查询原生 BigQuery 表,由 BigQuery 负责处理。这些集成消除了对自定义数据管道的需求,使应用程序和 AI 代理能够无缝地基于合并的运营数据和 Lakehouse 数据采取行动。现实应用案例包括欺诈检测、个性化推荐和动态定价,其中 Lakehouse 提供的历史背景信息可 informing 数据库中的实时决策。数据团队还可将精心整理的表一次性发布到 Iceberg,允许多个应用程序就地读取。直接 Iceberg 访问允许像操作其他 PostgreSQL 表一样注册和查询 Iceberg 表,从而受益于内置支持和列式引擎。AlloyDB Sync 解决了需要极低延迟读取非频繁变更数据的需求,通过在 AlloyDB 中创建可刷新的本地副本来实现。Lakehouse 联邦则面向那些在 BigQuery 中拥有大量历史数据的组织,将处理下推至 BigQuery 并仅返回结果。集成方式的选择取决于数据位置、应用程序读取模式以及延迟要求。