在NVIDIA Dynamo上构建Pinterest的VLM服务栈
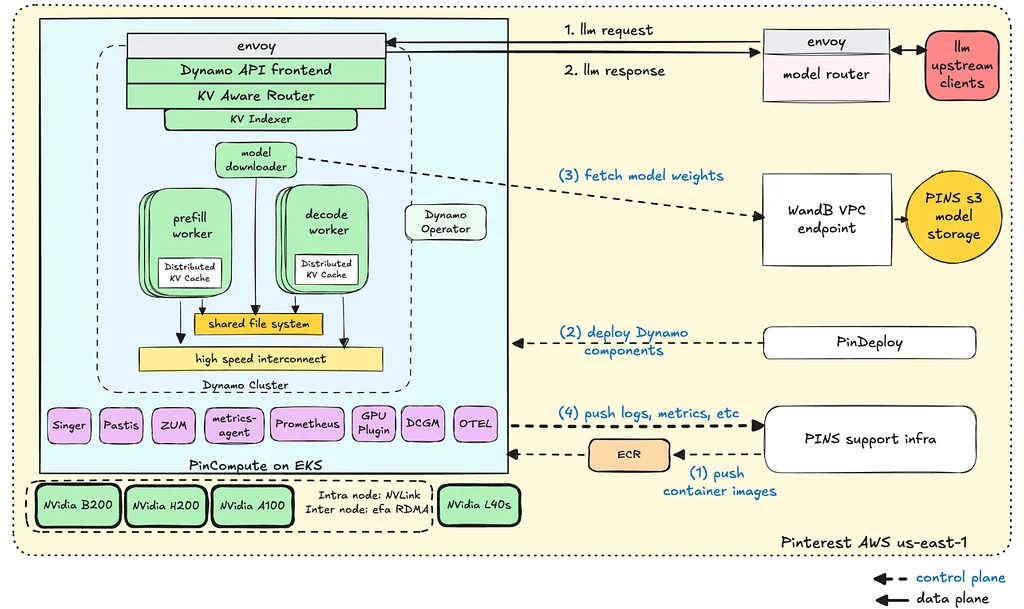
Pinterest 利用视觉 - 语言模型(VLMs)增强其视觉搜索与发现平台。这些模型对于驱动 Pinterest Assistant 和混合搜索等新功能至关重要。Pinterest 对开源 VLM 进行定制,以满足其特定的产品需求和规模要求。部署 VLM 面临超越传统纯文本大语言模型(LLM)的独特挑战,包括处理多张图像以及更大的键值(KV)缓存。为此,Pinterest 基于 NVIDIA Blackwell GPU 和 NVIDIA Dynamo 构建了其 VLM 服务栈。Blackwell GPU 为高需求 AI 工作负载提供了卓越的计算吞吐量和内存容量。Dynamo 提供分布式编排层,以优化整个服务路径上的多模态推理。VLM 的请求负载更为复杂,需要图像下载、预处理和提示构建。VLM 服务中的预填充(prefill)阶段通常占主导地位且计算成本高昂,因此需要先进的缓存管理。多轮 VLM 交互进一步增加了服务复杂度,原因在于不断演变的视觉上下文以及更重的预填充需求。管理 KV 缓存的内存压力至关重要,需要采用如 KV 感知路由和卸载等策略。Pinterest 的解决方案采用了解耦的预填充与解码、结合 LMCache 的 KV 缓存卸载,以及 Dynamo 和 vLLM 中的多模态支持。他们还实现了自定义投影嵌入,以降低处理大规模视觉上下文的成本。这一优化的 VLM 服务栈显著提升了性能,在首 token 时间(Time-to-First-Token)方面取得了实质性增益。