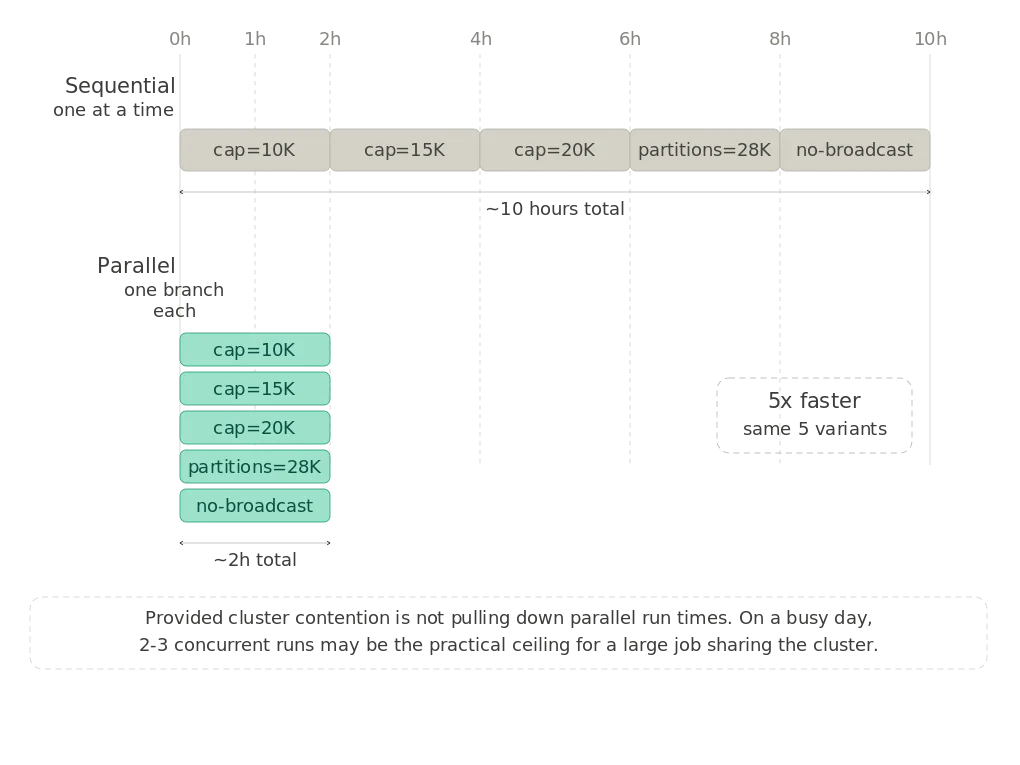
Netflix TechBlog | Medium 中文 关注 在睡眠中(甚至是在飞机上)运行 Apache Spark 实验 Netflix 的成员会话处理器(member-sessionizer)是一项关键的数据管道,用于处理数十亿条事件以构建用户观看会话。在 Netflix 的生产规模下,标准调试方法失效,因为诸如内存溢出(Out-Of-Memory)等问题仅在大规模且未采样的数据集上因数据倾斜而显现。作者的突破在于将关注点从加速单次运行转变为支持多个并发实验。这一目标通过利用 Dataflow 的分支驱动开发来实现,从而隔离每个测试变体。通过对调度器进行参数化,并为每个实验分配独立的分支和输出表,多个测试得以同时运行。这将总执行时间从每次测试数小时大幅缩短至最长单个作业的持续时间。引入 AI 代理来管理运行大量并行实验的运营复杂性,自动化配置更新、作业触发和指标轮询。这使得作者得以摆脱繁琐的手动检查,能够立即比较结果。在 Netflix 的云开发环境中保持持久的 tmux 会话对于防止多小时的 Spark 作业因网络中断或笔记本电脑关闭而中断至关重要。核心性能瓶颈被识别为 collect_list 算子将整个事件包缓冲在内存中以及低效的数据结构。具体而言,将会话 ID 更改为 UUID 字符串并使用 Scala Option 处理字段显著增加了内存占用。此外,臃肿的字符串属性为每个事件增加了不必要的重量。修复措施包括从 Option 中解包原始字段,并通过移除未使用的属性精简事件包。将与会话无关的元数据提升至会话头部。两项反直觉的发现凸显了 Spark 内存管理的复杂性:缩小行数可能通过强制广播连接而触发更快的内存溢出;自适应查询执行(Adaptive Query Execution, AQE)通过广播哈希连接在内存中静默累积大量数据。调整 AQE 的广播阈值解决了这一问题。一套纪律严明的日志系统追踪了每个实验、其配置和关键指标,形成了单一事实来源,并强制进行隔离的变量变更。一个错误在于在 Spark Window 阶段之前测试会话上限修复,该操作在截断前进行了内存缓冲。最终的修正修复将截断操作上移至上游,以防止内存膨胀。尽管这些调优工作解决了即时问题,但将整个会话聚合为单行这一根本数据形状在未来仍构成扩展挑战。 Running Apache Spark experiments in my sleep (and on a plane) netflixtechblog.com Netflix TechBlog | Medium 中文 RSS thenote.app

collect_list算子将整个事件包缓冲在内存中以及低效的数据结构。具体而言,将会话 ID 更改为 UUID 字符串并使用 Scala Option 处理字段显著增加了内存占用。此外,臃肿的字符串属性为每个事件增加了不必要的重量。修复措施包括从 Option 中解包原始字段,并通过移除未使用的属性精简事件包。将与会话无关的元数据提升至会话头部。两项反直觉的发现凸显了 Spark 内存管理的复杂性:缩小行数可能通过强制广播连接而触发更快的内存溢出;自适应查询执行(Adaptive Query Execution, AQE)通过广播哈希连接在内存中静默累积大量数据。调整 AQE 的广播阈值解决了这一问题。一套纪律严明的日志系统追踪了每个实验、其配置和关键指标,形成了单一事实来源,并强制进行隔离的变量变更。一个错误在于在 Spark Window 阶段之前测试会话上限修复,该操作在截断前进行了内存缓冲。最终的修正修复将截断操作上移至上游,以防止内存膨胀。尽管这些调优工作解决了即时问题,但将整个会话聚合为单行这一根本数据形状在未来仍构成扩展挑战。