ZenteiQ 借助由 llm-d 驱动的 GKE 推理网关,将批量推理性能提升了 4 倍。
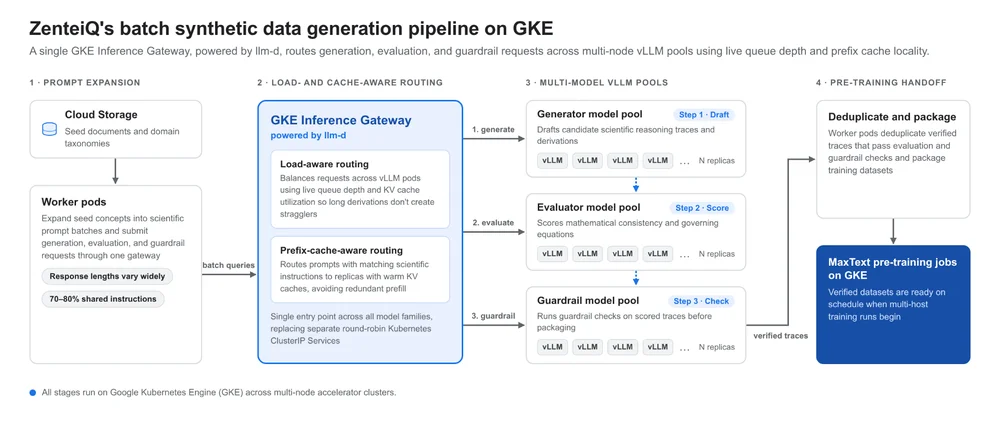
ZenteiQ 是由印度科学研究所(Indian Institute of Science)孵化的一家 AI 初创公司,致力于构建主权科学基础模型。这些模型需要理解物理学、方程及数值求解器,从而区别于通用语言模型。ZenteiQ 采用大规模合成数据生成管道对这些模型进行预训练。该管道生成了数十亿个推理 token,涵盖复杂的科学推导与求解器验证。此前,ZenteiQ 在 Kubernetes 上遭遇了路由瓶颈,导致引擎队列分布不均并产生冗余计算,这显著拖慢了数据生成进程并推迟了预训练。为克服这些问题,ZenteiQ 部署了由 llm-d 驱动的 Google Kubernetes Engine(GKE)推理网关。该解决方案为其推理请求提供了智能的、基于负载与缓存感知的路由机制。GKE 推理网关实时监控其服务节点上的实时队列深度与 KV 缓存利用率,有效路由请求,避免瓶颈并复用缓存的提示前缀。这种智能路由大幅提升了吞吐量,每日生成的 token 数量从 14.7 亿增长至近 60 亿,同时也确保了预训练运行的可预测性。ZenteiQ 计划利用此架构支持未来的高级 AI 训练阶段。