The Daily WTF 中文 关注 Daily WTF是一个由Alex Papadimoulis创建的以编程为导向的幽默博客,基于软件开发和技术世界的故事。它主要集中在项目问题、代码示例和与IT相关的趣事上。该网站包含了许多开发者分享的真实世界经验,他们在工作中遇到的奇怪和有趣的事情,无论是技术性的还是个人性的,但总是与相关技术相关。 The Daily WTF thedailywtf.com RSS feeds.feedburner.com The Daily WTF 中文 RSS thenote.app
CodeSOD:约翰·凯奇变量 David C,一位编写用于程序化动画的 C++ 代码的开发者,承认自己因代码的“一次性”特性而未将质量作为优先考量。然而,某一行代码让他开始质疑这种做法。该行代码大量采用基于数组的参数传递,导致变量命名难以理解。例如,length4_3_3 看似是一个变量,实则被描述为一个大小为 1 的范围表达式。这种命名约定无法传达其所持数据的含义。尽管该代码本意是临时的,David 也认识到代码很少真正可以随意丢弃。他反思了在不同项目中复用代码的倾向。作者指出,即便是“一次性”代码也可能产生持久的影响。最终,他建议读者努力提升代码质量。 CodeSOD: The John Cage Variable thedailywtf.com +1
最弱的腿 TruStage 是一家人寿保险公司,于 2026 年 7 月 10 日遭遇重大网络安全事件,数月后其主要业务功能仍仅部分可用。该公司仍在努力评估此次入侵的范围,尚未确定哪些数据遭到泄露,也未明确服务何时能完全恢复。此次事件影响了其保险运营,而支持信用合作社的银行系统则保持正常运行。该事件已引发多起诉讼,凸显了保险行业中复杂的中介角色。保险流程通常涉及多个合作伙伴,例如 Ethos,其利用人工智能将客户与保单进行匹配;以及 Family First Life(FFL),该公司与 TruStage 等企业合作。由于网络安全事件导致 TruStage 无法处理付款,致使保单失效。保单失效不仅造成代理人佣金损失,也使 Ethos 和 FFL 等合作伙伴公司面临退款索赔。FFL 总裁 Shawn Meaike 在一次行业会议上公开批评 Ethos,称其为合作伙伴关系中的“最薄弱环节”,并要求其道歉。Meaike 在台上羞辱 Ethos 员工 Dylan Cummings 的一幕,被视为尤为令人尴尬的时刻。整个事件充分暴露了 TruStage 在网络安全和灾难恢复方面的严重失败,对客户造成负面影响,并引发行业混乱。最终,该事件揭示了 TruStage 的制度性无能,以及依赖单一承保方的 AI 驱动型保险初创企业所存在的经营模式问题。 The Weakest Leg thedailywtf.com +1
错误'd:天哪 作者反思了人工智能的迅猛发展,指出人类对 AI 局限性的嘲讽正转向未来 AI 可能嘲讽人类缺陷的图景。过去一年里的一系列幽默观察,凸显了各种与 AI 相关的怪癖与烦恼。Timothy W. 简洁地表示:“数学太难了”,以此讽刺性地欢迎 AI 统治者。AInonymous 抱怨手机未经请求地涌现出各类 AI 功能。The Beast in Black 批评了一款 AI 图像分类工具,认为其缺乏智能。Marius B. 分享了一张令人发笑的旧截图,展示了 Bing 对“熊主人”这一查询给出的怪异建议。Olivier 指出了一个幽默的 AI 翻译错误:AI 先提供帮助,随后却索要基本信息。整体情绪是 amusement( amusement 在此语境下可译为“会心一笑”或“忍俊不禁”)与一丝对 AI 当前状态及其快速演变的困惑。这些轶事捕捉到了一个特定时刻:AI 既令人印象深刻,又滑稽地存在缺陷。其幽默感源于 AI 出人意表的行为以及人机互动的不断演变。 Error'd: Ai Dios Mio thedailywtf.com +1
CodeSOD:2013年复古 Watson 的一条评论指出了 Oracle 发布的 GPL 许可代码中存在的一个问题。该评论具体指出,版权声明中包含大量重复的"2013"年份,这种过度的重复暗示可能存在自动生成的错误。作者因这一明显缺陷而对代码质量表示缺乏信心。该代码本身采用 GNU 通用公共许可证第 2 版(GNU General Public License version 2)许可,不提供任何保证,包括对适销性或特定用途适用性的默示保证。完整的许可证文本可从自由软件基金会(Free Software Foundation)获取。版权声明中多处重复出现"2013"年份是所提出的主要关切。此问题引发了对该文件发布历史及整体代码完整性的质疑。 CodeSOD: Vintage 2013 thedailywtf.com +1
CodeSOD:极度单行” 代码自动格式化是保持可读性的标准且必要的实践。不采用某种形式的自动格式化工具(无论是集成到编辑器中还是作为构建步骤运行)没有任何正当理由。就连许多 IDE(如 Visual Studio)也会积极自动化此过程。因此,来自古老 ASP.NET 应用程序的代码示例显得尤为令人费解。Page_PreInit 函数完全包含在一行内,紧接着便是 Page_Load 的声明。这种格式化决策导致关于 Logic() 函数调用位置的显著困惑。原始开发者还实现了用户代理嗅探,以检查浏览器字符串中是否包含"Safari"。如果检测到"Safari",则会将 Page.ClientTarget 设置为晦涩的"uplevel"值。这体现了命名规范不佳、用户代理嗅探以及使用字符串而非枚举的混合问题。最令人担忧的是,这种有问题的模式在应用程序的多个页面中重复出现。这表明开发者有意选择了这种令人困惑且不可读的风格,并将其视为可复用的可行解决方案。 CodeSOD: Extremely One Line thedailywtf.com +1
CodeSOD:一种奇特的排序” 该脚本旨在报告所有 Active Directory 用户及其最后登录时间,但采用了低效且复杂的实现方式。它通过遍历字母表中的每个字母来筛选用户账户,这并不能保证完全按字母顺序排序。对于每个字母,脚本创建一个新的 DirectorySearcher 对象,显式仅请求"name"属性,然后查找所有匹配的账户。随后,对于每个检索到的名称,脚本又创建另一个 DirectorySearcher。该新搜索器用于查询特定用户账户以获取其所有属性。尽管用户名搜索预期仅返回一个结果,但仍使用 FindAll() 方法,返回一个数组。这导致需要不必要的循环来遍历单个元素的数组。最后,脚本输出用户名称与最后登录时间,并用逗号连接。由于脚本设计中存在重复的搜索器实例化、冗余查询以及不合逻辑的筛选方法,其整体设计极为低效。尽管存在这些缺陷,该脚本能够生成供管理层使用的 CSV 文件,因此在组织内被视为“关键任务”。 CodeSOD: An Odd Sort thedailywtf.com +1
CodeSOD:我存在 Greta 在一个古老的 Pascal 开发环境中遇到一个 bug:她的程序报告某些文件不存在,尽管这些文件实际存在。她将该问题追踪至系统库中的 FileExists 函数。该函数依赖于 FileAge,后者用于获取文件的最后修改时间戳。FileAge 又调用 FileTimeToDosDateTime 来转换时间格式。关键缺陷在于 FileAge 对 FileTimeToDosDateTime 返回值的处理方式。FileTimeToDosDateTime 返回一个布尔值以指示成功或失败,并在失败时设置错误代码。然而,FileAge 并未检查该布尔返回值。如果 FileTimeToDosDateTime 失败,FileAge 仍会返回 -1。因此,FileExists 将 -1 解释为文件不存在。Greta 所遇特定 bug 的根本原因是写入文件的进程未设置“最后写入时间”。由于缺乏有效的最后写入时间,FileTimeToDosDateTime 调用失败,导致 FileAge 返回 -1,从而使 FileExists 错误地报告文件不存在。这凸显了系统库中一个常见问题:细微的错误处理缺陷可能导致严重的功能 bug。 CodeSOD: I Exist thedailywtf.com +1
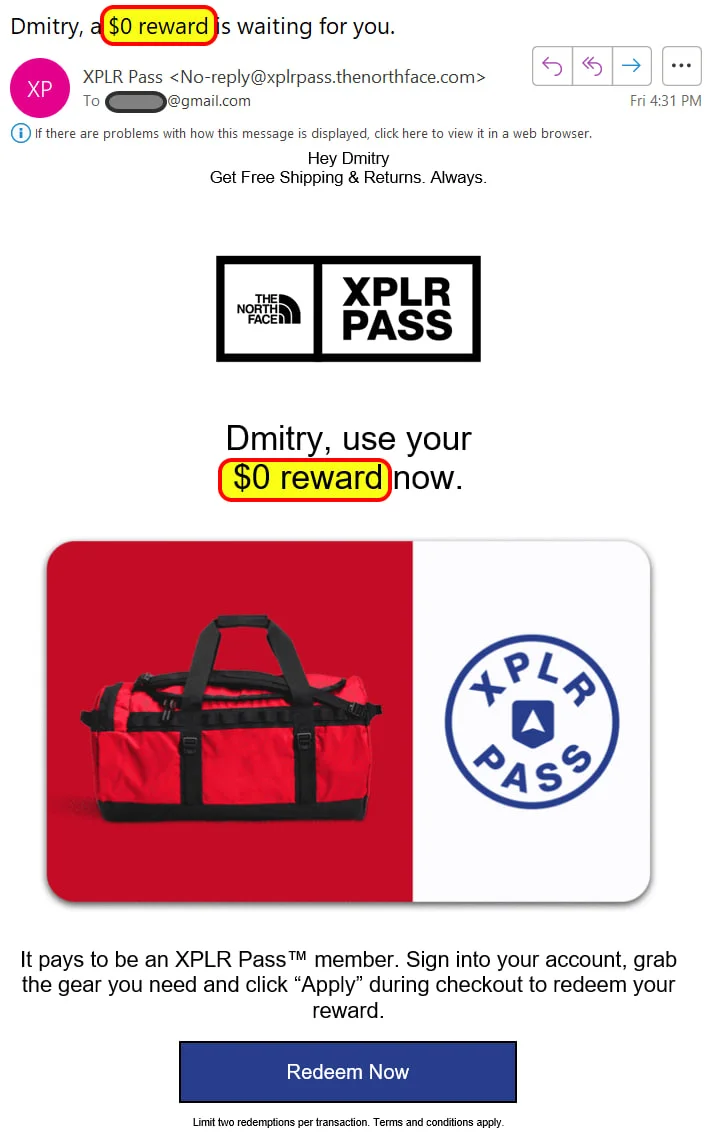
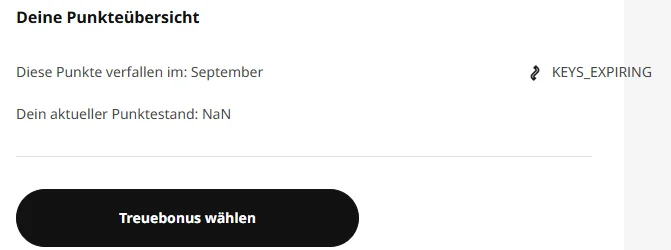
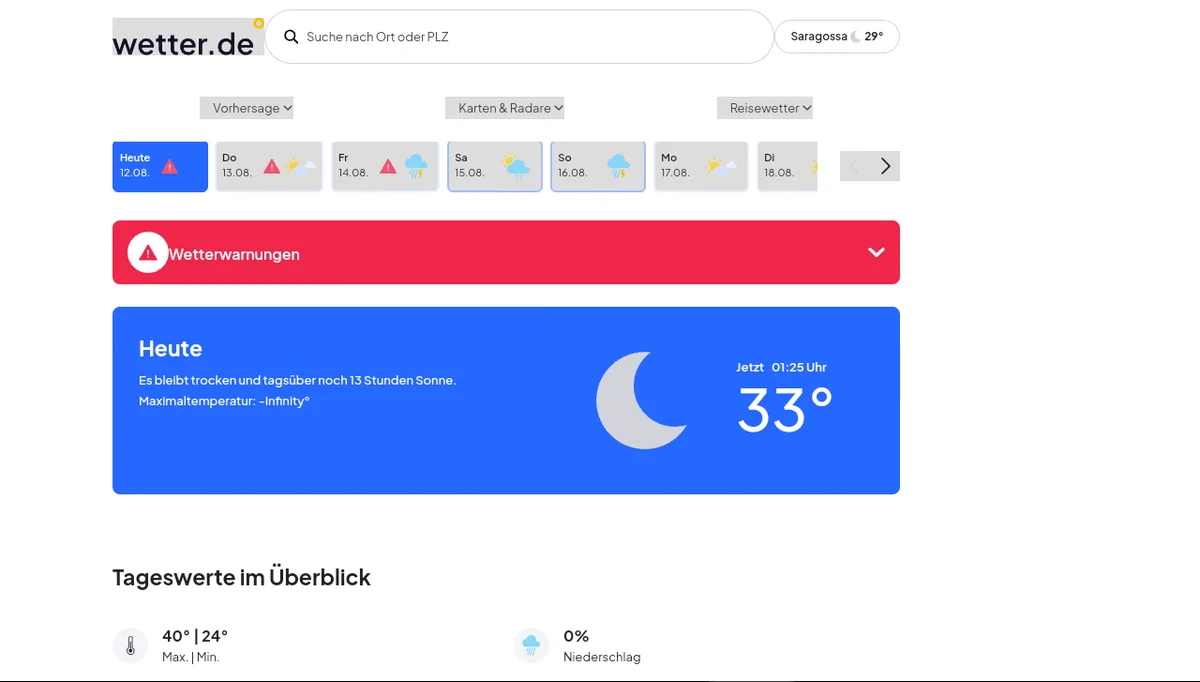
错误'd:无回报 文本突出了若干将"0"置于负面或无回报语境中的实例。Dmitry K. 收到了 The North Face 赠送的“令人恐惧的蓝色按钮”,暗示其回报为零。Renan 对 Steam 上《最终幻想》的 0% 折扣表示失望。Reinier B. 抱怨荷兰铁路欠他 2.25 欧元,却称退款将在“大约 0"时发生,导致困惑。Philip 发现其与 Office Depot 的关系缺乏回报,因该公司本地门店关闭后,其账户余额显示为 0 美元。一位匿名用户的应用奖励积分将在 Unix 纪元到期,实质上变得一文不值。Emily 面对复杂的奖励积分转换,疑惑自己最终是否会得到 -0.01 积分,凸显了此类计算的令人沮丧之处。共同主题是,"0"往往象征缺失、失效或令人困惑的财务情境。这些例子表明,零值常被感知为一种缺陷,而非中性或积极的结果。各种情境凸显了人们对无回报奖励的普遍沮丧。 Error'd: Unrewarding thedailywtf.com +1
“一点 DNS" DNS 中的 CAA 记录类型允许域名所有者指定哪些证书颁发机构(CA)有权为其域名颁发证书。该记录类型最初在 RFC 6844 中定义,随后由 RFC 8659 更新,但其核心概念保持不变。CAA 记录的一个关键特性是“颁发者关键”(Issuer Critical)标志,旨在促使颁发机构在颁发证书前验证该记录。该关键标志被设计为标志位掩码的第 0 位,因此启用它应使用值 128。然而,一种普遍的误解导致许多人使用值 1,将第 7 位误认为是关键标志。这种误解在尚未仔细阅读 RFC 的用户中广泛存在。Let's Encrypt 等证书颁发机构面临两难:要么严格遵循规范并拒绝配置错误的记录,要么为了保持功能而迁就这种广泛存在的错误。它们选择了后者,实际上将值 1 接受为关键标志的别名。这一决定承认了用户错误的现实情况,而非严格遵循原始规范。所提供的 filterCAA Go 代码片段展示了这一机制在实际中的处理方式。它过滤“issue”和“issuewild”标签,并检查是否存在未识别的关键标签。值得注意的是,代码会检查标志是否设置为 128(正确值)或 1(广泛使用但不正确的值),以判断是否存在未识别的关键标签。同时接受这两个值反映了对关键标志方面广泛用户错误的迁就。作者质疑在此类标志中使用位掩码的明智性,因为这导致了混淆和错误,并建议更简单的标志机制可能更具可读性且不易出错。尽管承认位掩码的实用性,但该轶事突显了其复杂性如何在实际实现中引发严重的运营问题。技术规范、用户理解与实际实施之间的相互作用是一个反复出现的主题。 A Bit of DNS thedailywtf.com +1
CodeSOD:异步目录 Vala 是一种专为 GNOME 设计的编程语言,具备类似 C# 的特性且性能接近 C。它支持使用 async/await 语义的异步编程,允许函数让出控制权。Vala 中的许多 I/O 库函数是异步的,例如 make_directory_async。然而,核心库缺少 create_directory_with_parents 的异步版本,该函数用于同步创建目录链。这一缺失可能是由于异步处理竞态条件的复杂性所致。作者 Eri 遇到了这一问题并实现了一个自定义的异步解决方案。Eri 的初始方法尝试从叶节点向上创建目录,将缺失的父目录收集到一个数组中,然后反向遍历该数组以创建这些目录。这种方法被认为不够优雅,因为它使用异常处理来控制流程。Eri 承认该问题的难度,尤其是管理异步竞态条件。文中展示了一个稍作改进的主循环版本,但该方法仍然复杂。尽管实现略显笨拙,Eri 的解决方案有效弥补了库功能的缺失。作者建议,一旦该函数正确实现,应将其隐藏起来。 CodeSOD: Asynchronous Directories thedailywtf.com +1
致命一击 作者临近退休时,被猎头挖角担任一个高薪的专业软件职位。入职流程起初进展缓慢,前六个月都在等待系统访问权限。面试官弗雷德(Fred)能力出众,并与作者建立了良好的关系。弗雷德指派作者分析公司的核心软件,以理解其架构并探索现代化改造的可能性。在作者尚未提交分析结果之前,弗雷德意外去世。这一事件在公司内部引发了混乱,而像作者这样的外包人员则被 largely 遗忘。随后的十八个月里,作者基本被忽视,利用这段时间搭建开发环境。在此期间,作者与一位同事共事,该同事持续批评管理层。作者的新经理态度敌对且轻蔑,勉强分配任务。公司似乎由一批年长员工组成,他们竭力维护现有系统,而作者作为新人试图引入自动化,却未获欢迎。在业务停滞的这段时期,作者为 TDWTF 网站撰写内容。最终,作者被解雇,本人亦无芥蒂。如今,作者在退休前的最后几年担任邮递员。作者强调,因工作压力导致猝死的风险是真实存在的危险。 A Mortal Blow thedailywtf.com +1
精选...:经典WTF:一种愚蠢专属语言 本文讨论了为定义“源”规范而创建领域特定语言(DSL)的过程。这些规范涉及特性与分层步骤,类似于复杂的文法。此前的一次实现未采用带有模式(schema)的 XML 以提升结构清晰度与规范性,而是选择了一种稳健性较差的方案:构建了一个依赖冗长正则表达式的 XML 模式规则以验证数据。该正则表达式长达 1,310 个字符,旨在强制实施文法规则。作者指出,这一方法存在诸多问题,导致出现缺陷;其中一项特定缺陷需要修复,作者亦以幽默方式提及此类复杂正则表达式所带来的负面后果。原文及其验证规则均以英语和德语提供。本文建议,采用具有适当模式的更结构化 XML 表示法将是更佳且更易维护的方案。最终,试图通过复杂正则表达式实现“省力”之举被证明效率低下且易出错。 Best of…: Classic WTF: A Dumbain Specific Language thedailywtf.com +1
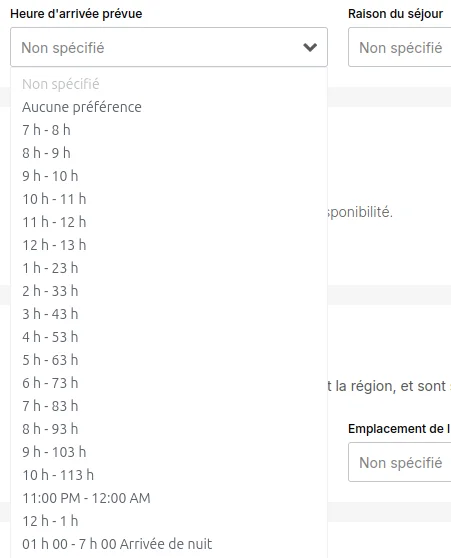
《Error'd: Good Time》 编辑承认在日历回忆上存在个人失误,并邀请读者分享来自各类网站的类似“日历故障”。C_Chell 在 IHG.com 上遇到了日期输入问题,导致无法完成酒店预订入住日期的表单填写。Dragoncoder047 报告了 GradImages 网站出现的"You Have -1 Month(s) To Order!"错误;该公司此前已因服务质量差且持续发送邮件而广为人知。Michael R. 发现了一个名为"Stansted Temporal UI 设计”的问题,显示入住时间为“明天 00:06",暗示了时间悖论。此外,Michael R. 还指出 Stansted 机场网站存在“方向混淆”问题。最后,Slaoput 强调了一个表单,其声明“出生日期为可选”,但在提交时却将其设为必填项。这些轶事共同揭示了一条普遍线索:网站设计与功能问题,尤其是涉及日期和时间处理方面的问题。 Error'd: Good Time thedailywtf.com +1
CodeSOD:火热进行中 由于性价比高且节能,分体式空调系统在老房改造中广受欢迎,但其对红外遥控器的依赖使得与家庭自动化系统的集成变得复杂。 一个常见问题源于这些系统内部的温度转换逻辑,特别是在摄氏度与华氏度之间转换时。一个试图将分体式空调集成到家庭自动化系统中的开源项目,揭示了其温度转换方法存在缺陷。该项目的代码使用查找表来实现摄氏度与华氏度之间的转换。这些查找表包含特定的、往往不准确的映射关系,导致与标准转换公式存在偏差。例如,18°C被错误地映射为65°F,而非更准确的64°F(四舍五入后)。 这些查找表的设计表明,其目的是对转换值进行近似处理,而非进行精确的数学计算。作者最初认为这是该业余项目的一种天真的优化尝试,但代码中的一条注释澄清说,这些是“基于遥控器的直接映射”。这表明,不准确之处源于遥控器本身。 遥控器很可能因其嵌入式微控制器的限制而使用查找表,该微控制器可能无法高效处理浮点运算。因此,当用户在遥控器上设置 72 华氏度(72F)等温度时,遥控器会在将命令发送至设备前,先在内部将其转换为近似摄氏度值(例如 22.5°C)。这种近似虽然在大多数情况下“足够好”,但会导致精密自动化出现不一致的情况。 作者认为,根本问题并不在于这个业余项目的代码或遥控器本身,而在于全球范围内持续使用非标准单位(华氏度),这导致了这些不精确的转换。 CodeSOD: Heating Up thedailywtf.com +1
你衡量什么 Rachel 加入了一个新团队,她的上司 Zane 强调以指标驱动的方式,专注于以最低成本最大化小部件(widget)的产量。自动化生产线涉及复杂的软件,由于测试限制,变更仅在真实生产环境中进行验证。Rachel 的初始任务是更新一个 Google Sheets 指标仪表板,该仪表板从六个数据库拉取数据,尽管用户始终更偏好 Excel。团队仅追踪输出指标,如“单位时间内生产的小部件数量”,缺乏详细数据来解释系统行为或瓶颈。例如,自动化质量控制扫描仪并未记录拒绝小部件的原因,甚至没有直接记录被拒小部件的数量。软件变更的评估基于整体输出指标,这使得验证变得困难,因为这些指标存在噪声,且受软件本身之外的外部因素影响。Rachel 尝试实施一项变更以记录被拒小部件,最初却因环境因素而非其代码导致的指标回退而受阻。由于测试运行有限且需考虑指标回退,简单的变更可能需要数周才能验证。Rachel 开始在代码中添加仪器化(instrumentation)以收集更详细的数据,希望构建一个有用的系统模型。然而,Zane 仍固守于对关键输出指标的即时改进。他驳斥了收集数据以理解指标为何如此表现的價值,声称此类诊断数据并非“关键指标”。这造成了 Rachel 对系统理解的渴望与 Zane 对顶层绩效指标的关注之间的根本冲突。Rachel 通过一种妥协策略解决了这一矛盾:确保她为改进顶层指标所做的任何变更都包含用于解释变更行为的仪器化。这一策略使她既能满足 Zane 对指标改进的要求,又能逐步提升系统的可观测性。最终,深入理解复杂系统相较于在没有全面洞察其驱动因素的情况下推动顶层指标,始终处于较低优先级。 What You Measure thedailywtf.com +1
代表线路:如此广阔的空间 “今日的代表性评论已超出空间。 int maxLen = getColumnSize(session, "audit", "text_value1") - 16; // 预留一些空间用于不,它并未延续到下一行,只是被截断了,除非是出于疏忽的合并所致。这就是完整的注释。显然出自大卫·切斯之手,《黑道家族》的创作者。我们可能预留空间的事情太多了。我们可以为甜点预留空间。为活动预留空间。为圣灵预留空间。为即兴发挥预留空间。[广告] ProGet 可为您的 NuGet 源提供安全与访问控制保障。了解更多。" Representative Line: So Much Room thedailywtf.com +1
世界杯故事 巴西一家软件公司被要求在 2014 年世界杯前开发一套警队数字化系统。该项目规模严重不足,与可用工程团队不匹配,导致工期设定不切实际。管理层雇佣了大量不合格人员,引发了“人月问题”。为弥补差距,工程师被迫进入高强度冲刺模式,超长时间工作以赶在截止日期前交付。一项拟推出的允许市民提交事件照片的功能被戏称为“ dick-pic 百科全书”,因风险过高而被否决。关键的警车追踪系统存在缺陷,源于贫民窟地区蜂窝网络连接不可靠。调试该问题需要一次在危险街区进行的危险随车体验。最终交付的系统质量低下且超出预算。该公司因此及其他类似项目面临诉讼,几乎濒临破产。叙述者因未获支付加班费及项目执行中的诸多问题而离开公司。 Tales from the World Cup thedailywtf.com +1
CodeSOD:大家庭” 这篇博客文章描述了一段存在问题的 PHP 代码。作者独自工作,出于宣泄和黑色幽默的目的分享此代码。为保护机密性,代码已被泛化,可能导致不一致之处。该代码获取数据并遍历,使用动态属性访问进行本地化以检索详细信息。随后,根据类别变量格式化成本,通过任意索引访问 $mot 数组。存在大量的 HTML 字符串操作,包括生成数量选择块。代码对时间数据进行 JSON 解码,表明日期以字符串形式存储。下拉列表使用 $mot 数组的值构建。最终,处理后的数据被插入模板。该过程对子项重复执行,导致代码近乎重复。此外,子项也可能拥有兄弟项,需要再次迭代,且逻辑相似。作者希望原始程序员最终能学会使用方法和函数。所提供的代码片段展示了主项和子项的初始数据获取与处理循环,包含复杂的成本计算与格式化条件逻辑。动态属性访问用于本地化和货币处理。HTML 片段用于数量和时间选择也被指出。主项、子项及兄弟项的代码重复性使得代码库效率低下。 CodeSOD: The Big Family thedailywtf.com +1
CodeSOD:锁死即亡 提供的 C++ 代码片段展示了一个用于捕获 Deadlock 异常的异常处理程序。捕获该异常后,代码尝试执行 retry。然而,retry 并非标准 C++ 关键字,很可能是一个宏。作者怀疑该宏是通过 goto 语句实现的。核心问题在于假设 retry 能够解决死锁。死锁发生在两个或多个线程被无限期阻塞,每个线程都在等待另一个线程持有的资源时。要使 retry 有效,它必须释放当前被死锁线程持有的资源。根据代码作者 Kevin 的说法,retry 宏并不释放任何资源,它只是简单地跳转回 catch 块的开头。这意味着线程仍然被困在死锁状态中。Kevin 指出,该系统此前已遭受大量死锁困扰。为此聘请了一位顾问,通过重新排序资源访问顺序并识别与互斥锁相关的问题来解决这些问题。然而,顾问实现的 retry 似乎无意中引入了更多的死锁。Kevin 幽默地推测,该顾问可能有意在其代码中添加了额外的死锁。 CodeSOD: Lock 'Em Dead thedailywtf.com +1
代表线路:双向故障 调试代码常导致一些奇特甚至无意义的表达式出现在生产环境中。其中一个实例涉及包含异常条件子句的 SQL 查询。该查询的问题部分为 WHERE (某些条件) AND (1 = 0 OR (1 = 1 AND (其他条件)))。这种结构允许通过操纵"1 = 0"部分,在始终返回行或根据主条件返回行之间切换。也可以将其配置为从不返回行,尽管其效用值得商榷。作者认为这些很可能是调试标志的残留,且从未被移除。此类残留标志表明代码可观测性存在不足。与许多此类标志一样,这些标志未加文档说明,且似乎自代码发布之初就已存在。该查询可能最初是分析师使用的临时工具,随后演变为永久存储过程。这些“死”标志的存在揭示了开发与部署实践中的更广泛问题。 Representative Line: Both Ways Bug Me thedailywtf.com +1
RCE作为特色 “最劣者统治”(Kakistocracy),即由最糟糕且资质最低者掌权,被引入为一个相关概念。一位名为贾里德·B(Jared B)的教师分享了他为一家由机械工程专业教授哈里(Harry)创立的教育科技公司工作的经历。哈里开发了一个 C 语言解释器,并围绕其建立了一家公司,提供基于 C 编程的 K-12 课程。其软件包含一个网络集成开发环境(IDE)以及一个本地安装的 Windows 版本,该版本包含一个用于远程运行 C 代码的守护进程(daemon)。然而,该守护进程缺乏身份验证机制,且绑定至 0.0.0.0,使得同一网络中的任何域名或计算机均可执行任意 C 代码。这些关键安全漏洞已存在多年,却未被哈里所雇佣的 exclusively 研究生开发人员察觉。该软件已安装于数千台学校计算机上。贾里德向哈里报告了这些问题,哈里发布了一个更新,声称进行了“安全改进”,但未能告知 IT 负责人更新的重要性。贾里德还在哈里的另一网站上发现了一个窃取 Cookie 的利用漏洞以及一个代码注入漏洞。后者暴露了数千条未加密的信用卡交易记录。尽管存在这些严重的安全缺陷和数据泄露,哈里的公司仍继续运营并获得了赞誉。评论者将这一情况与一位其认识的人进行了对比:后者固守于过时的技术,却未危及整个教育体系。 RCE As a Feature thedailywtf.com +1
Error'd:失败,失败后,失败后…… Foo 分享了一个 Chromium 错误,其中帧延迟为负值,并对其消息中的逻辑提出质疑。Foo 还讲述了一次西班牙日食期间出现的显著温度骤降,降幅远超预期。dragoncoder047 对标题进行了评论,暗示存在缺陷。Chris A. 向新墨西哥州致意,并指出 DOT 网站上存在未完成的按钮。Basti 展示了一个“失败失败”的场景,对成功与失败感到困惑。” Error'd: Failure, After Failure, After Failure... thedailywtf.com +1
代表行:我们共同注册 作者将糟糕软件文档带来的挫败感,与硬件数据手册撰写不当所引发的更大挑战进行了对比。为集成电路开发者而言,获取准确且完整的文档至关重要。然而,数据手册往往内容不全、信息不准,甚至以不同语言呈现。现代芯片的复杂性要求详尽的数据手册,但部分厂商提供的信息不足,迫使用户不得不逆向工程其功能。数据手册与实际芯片行为之间的差异可能导致严重错误,例如误认电源引脚而损坏器件。尽管部分厂商能产出优秀的数据手册,但嵌入式领域的成本考量常导致硬件文档质量低下。作者回忆了一个具体案例:某芯片的数据手册中描述了一个“超级用户神奇功能使能寄存器”,该寄存器被幽默地缩写为"SUFFER",反映了开发者在应对困难嵌入式项目时的体验。启用此功能旨在让高级用户修改调试行为。该寄存器的复位值为全 1,表明其默认处于使能状态。"SUFFER"这一寄存器名称恰如其分地概括了处理此类棘手文档时的感受。 Representative Line: We All Register This thedailywtf.com +1
CodeSOD:重返实验室” Matlab 受到科学家和研究人员的青睐,却令许多程序员望而却步。一个使用 Matlab 的团队在生成用于存储及后续参考的受试者特异性图像时面临挑战。现有约束使其在当前配置下难以完成该任务。一名名为 Jude 的程序员提出了一种变通方案以解决此问题。所提供的 Matlab 代码旨在处理实验触发数据。该代码在 for 循环中使用 switch 语句遍历不同类型的触发事件。代码试图通过计数刺激并处理各种响应与非响应场景来重建预期的模式。代码中的注释突出了复杂的逻辑以及潜在的数据损坏问题。其中一条注释明确指出,由于对数据正确性存疑,需标记整个试次予以删除。经发现,所提供的日志中有相当一部分代表了不同的、未知的实验。 CodeSOD: Back to the Lab thedailywtf.com +1
漂浮 作者描述了一次从 Microsoft 平台迁移到另一 Microsoft 平台的数据迁移任务,期间遇到了一个意外问题。最初,数据提取和加载由 SSIS 处理,但作者转而使用 PowerShell 以获得更精细的控制。目标是将从本地 SharePoint 迁移客户文档及其元数据至 SQL Server 数据库。其中,客户编号字段在 SharePoint 中存储为 Number 类型。在底层实现上,SharePoint 的 Number 字段以 Double 表示,足以准确存储十位数字。然而,SSIS 生成的 SQL Server 架构将该字段定义为'float'数据类型。作者在 PowerShell 脚本中错误地假设.NET 中的'float'类型会与 SQL Server 的'float'类型完全对齐。出现该不匹配的原因是:SQL Server 的'float'默认采用双精度表示,而作者未意识到这一表示差异。因此,在数据传输和转换过程中,较大的客户编号因精度损失而丢失了末尾几位数字。测试人员起初未能发现该错误,直到全量数据加载阶段才暴露问题。团队不得不识别出受损的编号,并在迁移后手动进行修正。 Floating Along thedailywtf.com +1
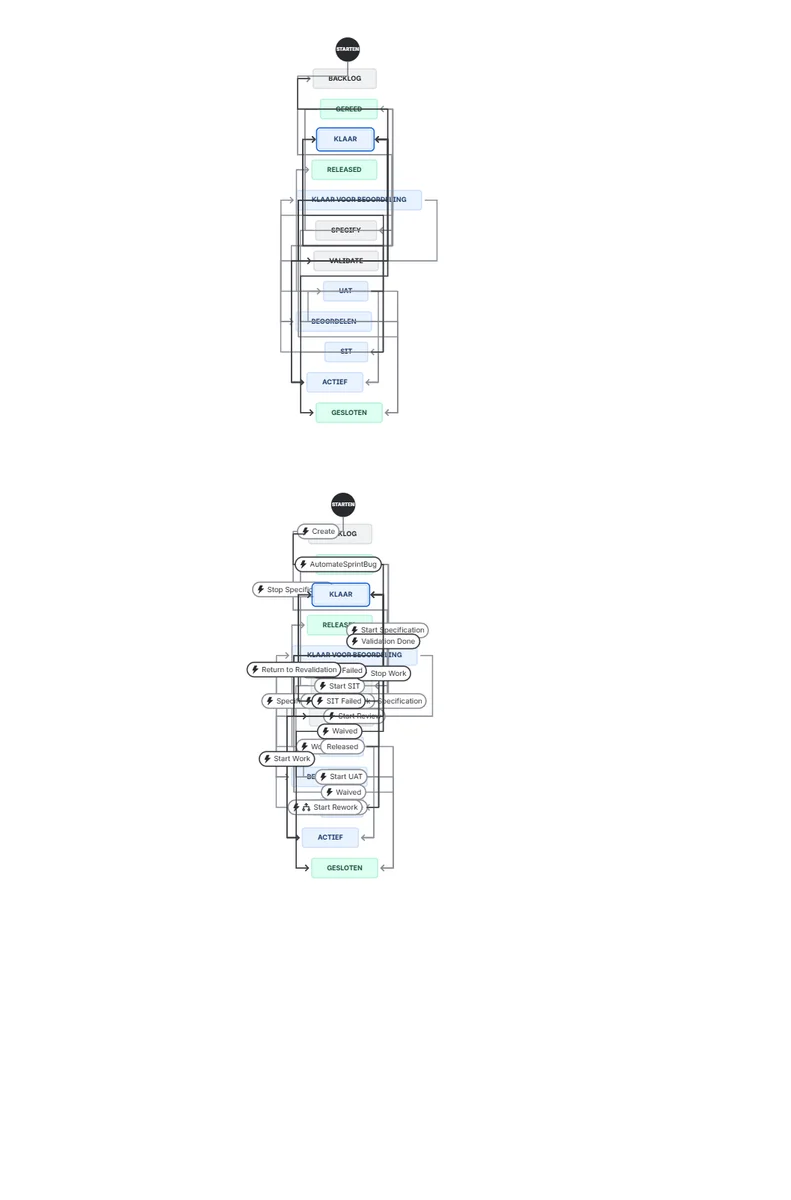
票务行业现状 软件开发不仅需要编辑器和编译器,还需要各种辅助工具。版本控制便是其中一项关键工具。然而,许多至关重要的开发工具或许并非“优秀”,而仅仅是“够用”。构建系统便是此类范畴之一,缺乏真正出色的选项。工单与任务管理工具同样属于这一存在问题的类别,其中 Jira 尤为备受批评。Jira 之所以被企业青睐,在于其功能丰富,但这不幸导致了复杂性,并迫使用户通过编程来自定义工作流。这往往导致项目经理陷入无尽的配置工作,而非推动实际的项目进展。Jira 允许将工单工作流定义为状态机,包括团队成员之间的自动路由。随后,文本介绍了 Klinsten 所遭遇的一个令人困惑的 Jira 工作流。所展示的示例工作流为双语(荷兰语与英语),且过于复杂。过多的状态与转换削弱了其本应明确团队工作顺序的目的。作者表达了沮丧之情,将这种体验比作想要关闭浏览器标签页。Klinsten 工作流的复杂性使其难以理解并有效使用。 The State of Ticketing thedailywtf.com +1
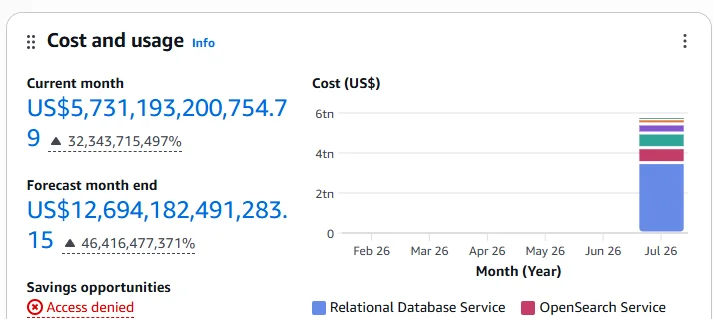
错误:0 到 0,耗时 0 秒 对话始于对巨额奖金的兴奋,Kivi S. 表现出热情,并发现一则包含许多零的广告,暗示奖金数额巨大。然而,并非所有人都分享这种兴奋,一些匿名用户表达了怀疑和冷漠,质疑成功的概念以及某些来源的可靠性。Michael R. 加入对话,就崩溃和隐藏 PHP 代码发表了幽默评论,同时批评了 30 年历史的网站 El Reg 的代码质量,认为其应更加成熟。对话被一则 BuildMaster 的广告打断,该平台是一个自助式发布管理平台,允许不同团队管理其应用程序,似乎与前述讨论无关。 Error'd: Zero to Zero in 0 seconds thedailywtf.com +1
CodeSOD:永远吃不到那块饼干 Maciej 是一名自由职业者,经常需要维护遗留的 PHP 代码。他发现一个项目缺少关键功能,具体而言是一个用于按时间间隔获取数据以填充数据的 HTTP 请求机制。此前多次尝试实现该功能均告失败。原始开发者在代码库中多次复制粘贴了类似的 cURL 初始化和配置代码块。这些代码块包含大量 curl_setopt 调用,旨在发起 HTTP 请求。其中一项选项 CURLOPT_TIMEOUT 使用名为 $interval 的变量进行设置,这可能表明对该选项功能的误解。核心问题未必在于 CURLOPT_TIMEOUT 的使用不当,而在于 curl_exec 获取的数据从未被使用。尽管请求看似成功,但检索到的内容被存储在变量 $s 中随后被忽略。这一疏忽让 Maciej 认为之前的开发者可能已启动任务但随后失去了兴趣,而非无法使请求正常工作。虽然该项目包含其他复杂的代码,但这一未使用的数据检索机制对 Maciej 而言尤为明显。 CodeSOD: Never Eating the Cookie thedailywtf.com +1
分支路径 Indika 正在审查她拉取请求(pull request)的评论时,她的老板 Bill 走了过来。Bill 指责她提交了该拉取请求,称这违反了团队政策。他坚持认为她未曾阅读开发者指南。Indika 确实阅读了公司范围的指南,但 Bill 为他的团队另有一份独立的指南,却从未与她分享。该指南禁止分支和合并,主张直接提交到主分支。Indika 与同事 Elise 确认,这项政策确实存在。Elise 解释说,当 Bill 在场时,团队会避免使用分支和拉取请求,而在其他时候则使用它们以保持良好的实践。几周后,Indika 在一个私密场合向 Bill 询问他对分支的政策。Bill 阐述了他的理由,源于多年的经验,他认为分支会导致冲突和过时代码。他相信对于内部团队而言,分支是不必要的,将其比作开发者被新奇的“闪亮玩具”所分心。Indika 沉思着他的话,望向树杈间嬉戏的松鼠。 Branching Paths thedailywtf.com +1
CodeSOD:公私合作伙伴关系 一名开发者在 API 的并发处理代码中发现了一处不一致。某状态属性的注释声明其应为私有,以防止误用;然而,该属性的定义却将其声明为 public。这一 public 定义允许外部调用者修改该状态,与注释所表达的意图相悖。作者指出,期望 API 用户阅读文档并遵守对 public 方法所建议的隐私性,这种情形颇具讽刺意味。此类不匹配在并发 API 中尤为令人担忧,误用的可能性及其可能引发的混乱被着重强调。尽管存在风险,代码仍保持公开可访问,仅靠注释作为警示。这凸显了一个常见的疏忽:文档与实现出现偏离。 CodeSOD: Public Private Partnership thedailywtf.com +1
十字路口 叙述者是一名技术支持无人机,决定辞去公司职务,拒绝晋升。不久后,新任人力资源主管莱拉发来邮件,邀请叙述者前往高管楼层,这引发了叙述者的紧张与好奇。叙述者与莱拉会面,莱拉对叙述者已故导师阿吉表达了哀悼。莱拉透露,她已解雇了叙述者曾举报的问题经理,从而建立了信任关系。随后,莱拉向叙述者提供了一个新变革管理团队的负责人职位,伴随重大晋升及内部招聘权限。尽管该提议极具吸引力,叙述者仍决定坚持原有计划,与朋友们共同从事自由职业。莱拉优雅地接受了这一决定,表示将提供支持,并对叙述者的离开感到惋惜。叙述者随后告知朋友梅根和雷纳尔多莱拉的提议,但他们同样致力于自由职业计划。桑贾伊也加入了他们的自由职业事业,而前同事“德古拉”提供了首个客户引荐。叙述者与朋友们成立了"RD IT Solutions",这是一家扁平化架构、承担所有费用的公司,并开始应对创业的挑战。叙述者重新找到了使命感,摆脱了过往的焦虑,并拥有了更健康的生活方式。他们的首个客户提出了一个意外挑战:要求通过传真获取网站代码。 The Crossroads thedailywtf.com +1
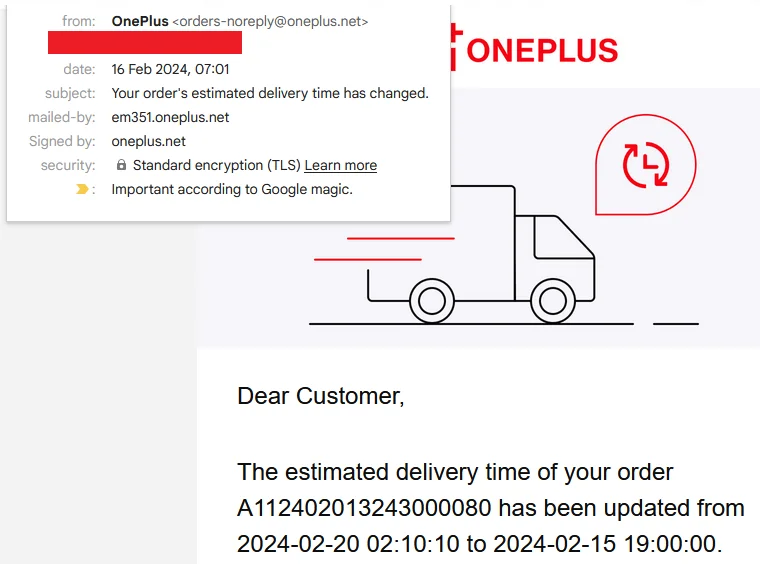
Error'd: Time Wounds All Heels 本文以幽默笔调探讨了若干技术 mishandling 时间的案例,导致荒诞情境。Robert 收到 OnePlus 的邮件,称其配送日期为“昨天”,暗示快递员需穿越时空。Kinkster 在 Fetlife 上发现一个有趣的漏洞:新成员的个人资料图片似乎在其加入社区前一小时就已发布。ERIC P. 分享了一张他 2008 年福特汽车的照片,该车因 GPS 日期回滚漏洞,显示屏竟显示来自 1024 周前的日期。Marc Würth 观察到 Netvibes 上出现奇特的抓取统计:某信息流在正常化之前,竟被提前 261 年抓取。一位匿名用户开玩笑称收到包裹的时间早于罗马征服不列颠,合并后的通知日期默认归零至 Unix 纪元。这些轶事凸显了与日期和时间计算相关的常见软件故障。本文将这些看似随机的漏洞与“时间旅行”主题相联系,强调时间处理代码常以意想不到的方式失效。所举案例涵盖各类软件与硬件。每个实例均以轻松方式呈现编程挑战。 Error'd: Time Wounds All Heels thedailywtf.com +1
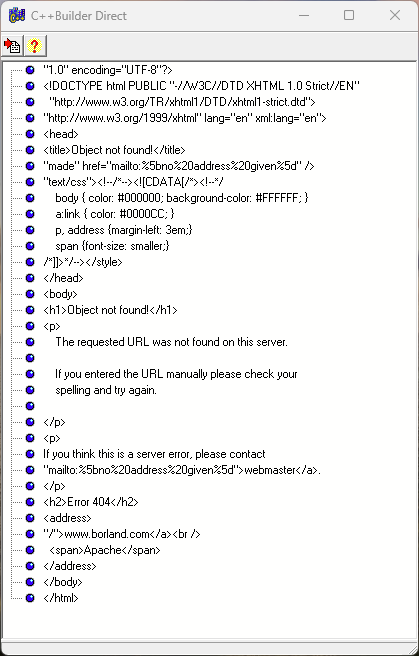
《一个更文明的年代》 Greta 在使用其“古代开发环境”(Ancient Development Environment)IDE 时遇到问题。IDE 的一项关键功能是向用户报告构建错误,但 Greta 的 IDE 中的错误显示存在严重问题。该错误表现不一致,未说明原因,也未提供任何解决方案。最主要令人困惑("WTF")之处在于其显示方式:在构建过程中,于未知条件下以任意弹窗形式出现。错误信息未说明问题所在,且以非用户可读的 XHTML 格式呈现,显示的是原始标记而非渲染后的页面。该标记以奇怪的树状视图展示,每一行源代码单独占一行。此外,XHTML 标记本身也是错误的。文本缺乏抗锯齿效果,表明其使用了遗留的窗口工具包。其中一个按钮“从互联网获取最新的 C++ Builder Direct 头条新闻”无法使用,这是网络集成尚属新奇时代的遗留物。有趣的是,另一个按钮“关于 C++ Builder Direct 的信息”则提供了一个令人怀旧的 90 年代网页设计 glimpse,仅包含基础的 CSS 说明。 A More Civilized Age thedailywtf.com +1
CodeSOD:连接状态 Frederick A. 在 ConferenceService 类的 IsCalling 方法中分享了一个空值检查问题。该方法试图通过访问 m_ConnectionService.Core.State.IsWebRTCConnected 来确定网络会议是否处于活动状态,但该对象链中的某些对象可能为 null。原始代码使用 try/catch 块来处理潜在的 NullReferenceException,若对象链中任何部分为 null 则返回 false。这种方法实际上掩盖了对象未初始化的根本问题。Frederick 建议使用 C# 的空值合并运算符(?.)作为直接修复方案,该方案可简洁地返回 false,若对象链中任何对象为 null,例如:m_ConnectionService?.Core?.State?.IsWebRTCConnected ?? false。尽管这是一个可行的解决方案,但作者认为这并非对深层架构问题的根本修复。核心问题在于连接状态的管理方式,建议应由一个合适的状态机来处理。依赖深层对象链并通过布尔标志表示关键状态信息,表明这是一个糟糕的设计选择。虽然完整的状态机实现将是更稳健的解决方案,但作者承认这需要大量的重构。然而,该示例为开发者提供了一个强有力的提醒:在状态管理策略上需谨慎考量,以避免此类空值检查的复杂性。 CodeSOD: Connection State thedailywtf.com +1
CodeSOD:永远选择那个选项 提供的代码片段展示了对 Optional 类型的误用,即便对于频繁提交者也是如此。它检查字符串是否为非空,然后将非空的 dto 包装在 Optional.ofNullable 中。这种做法抵消了 Optional 的预期优势,即优雅地处理可能为 null 的值。本质上,它规避了 Optional 为装箱类型提供的便捷语法糖。虽然孤立来看并非固有缺陷,但这种模式在整个代码库中普遍存在。作者指出,Optional 类型被广泛散布,甚至出现在不返回可空类型的函数中。这种广泛且错误的 Optional 应用并未提升代码质量或减少缺陷,反而助长了 buggy 且易出错的代码。作者对此问题能否得到修复表示怀疑。这凸显了一个常见问题:强大的语言特性被误解并误用。过度的装箱与拆箱增加了不必要的复杂性,最终违背了使用 Optional 以防止空引用异常的初衷。本例作为一个警示故事,说明了现代编程构造的不当采用。 CodeSOD: Always Take the Option thedailywtf.com +1
减少填充 在大型机上常见的平面文件数据库将数据存储在定长字段中。一条典型记录如"JOHN SMITH 12343rd St"依赖于已知"JOHN"占用 8 个字符、"SMITH"占用 8 个字符等。这种刚性结构使得修改(例如添加中间名缩写)极为困难,通常要求创建新表、进行数据迁移,并更新所有消费该数据的软件。为缓解这一问题,聪明的开发人员引入了“填充(padding)”,即在记录中预留额外字符。例如,一条记录可能以 16 个未使用的字符结尾。当需要新增字段(如中间名缩写)时,可以通过缩减填充空间来插入该字段,从而避免更改记录的总长度。这种方法虽不优雅,但可避免昂贵的模式重构和数据重排。填充通常分布在记录的各个部分,允许新列消耗这些预留空间。尽管填充空间最终可能耗尽,但这一策略显著延长了平面文件模式的运行寿命,而无需进行大规模重构。Brenda 的团队支持一个使用此类 VSAM 平面文件的大型机系统,因此需要将数据提取到现代关系型数据库(RDBMS)中。为此创建了一个 ETL 流程,大型机团队提供了描述文件结构的“拷贝书(copybook)”。然而,ETL 开发人员错误地处理了填充,导致字段被拆分,使得部分填充被当作独立的数据元素。起初这似乎无害,因为报告中的填充字符会被剥离,且通过连接字段即可重建数据。关键错误在于仅针对生产环境的大型机进行了测试,而该环境当时没有正在运行的功能会消耗填充空间。当这些功能在生产环境的大型机上上线后,ETL 流程生成的报告便因混入了原本被占用的填充数据而遭到损坏。由于 ETL 开发人员是合同工,且其解决方案基于有限的测试“按设计运行”,他们拒绝重新处理。因此,大型机团队被迫寻找其他填充字段,以避免影响现有报告。 Lose Some Padding thedailywtf.com +1
《Error'd:我相信越橘》 有一人强烈表示,宜家肉丸胜过其家具。另一人简(Jan)也表达了对这家瑞典巨型商店的难以估量的忠诚。Jeffphi 发现为瑞克·斯普林菲尔德(Rick Springfield)演唱会挑选座位的过程出乎意料地困难,最终带着未解的疑问离开。理查德·H(Richard H.)在撰写邮件时遭遇了一个意外且令人沮丧的错误提示,质疑微软的软件测试。一位匿名用户留下了一句侮辱,表明对某未指明事物的负面体验。WeaponizedFun 指出,OnSolve 公司要求用户保护其用户名,却拒绝向用户披露该用户名,这构成了讽刺。真正的秘密被定义为仅一人知晓的事物。OnSolve 关于用户名的政策直接体现了这一概念。最后,一则广告提供了一份免费指南,帮助用户自信地规划 .NET 9 迁移。 Error'd: I Believe In Lingonberries thedailywtf.com +1
CodeSOD:负面日 .NET 中 TimeSpan 结构体的源代码包含一条注释,解释其功能。TimeSpan 表示一个可正可负的持续时间。内部存储为毫秒数。这种表示方式对于小时和天等单位效果良好,但在处理更长周期时会出现精度问题。例如,月份的天数可能在 28 至 31 天之间变化;同样,一年可能有 365 或 366 天,而一个十年可能包含一至三个闰年。正是这些不一致性导致 TimeSpan 结构体不提供处理年或月份的方法。文中提到的"364 天”作为一年的长度是一个小错误,作者称之为“手指误触导致的拼写错误”,并不影响代码的行为。该注释在代码中已存在十二年且未作任何修改。TimeSpan 类本身本质上只是一个毫秒包装器,也未曾发生变化。更复杂的日期计算,如添加月份或年份,由其他日期时间对象处理。虽然这并非重大问题,但该注释及其历史沿革值得注意。TimeSpan 类还揭示了已弃用的构造函数以及对旧版 .NET 版本(包括 Silverlight)的编译时支持。Silverlight 是一项已废弃的技术,凸显了该类的长期存在。 CodeSOD: Negative Days thedailywtf.com +1
代表线路:奇妙之物 一条提供的注释称某函数“做了些了不起的事”。文本作者表示担忧,由于文本缺乏语气,“了不起”一词的歧义可能导致误解。Mark W. 澄清称,该注释并不代表整个代码库,其余代码库编写良好。尽管如此,当前注释仍能有效描述其所在代码库的特定部分。 Representative Line: Something Wonderful thedailywtf.com +1
CodeSOD:回到过去,遥远的过去 Windows Presentation Foundation 是 Windows 的一个 UI 框架,它支持控件进行数据绑定,这意味着文本框可以与模型类中的数值字段关联。该框架需要提供关于如何转换自定义类型的说明,这正是 IValueConverter 接口发挥作用的地方。该接口包含两个方法:Convert 和 ConvertBack,可用于在不同类型之间转换数据。实现该接口的类可用于将颜色转换为画笔等场景。然而,该接口的 API 并不受欢迎,其命名约定也令人困惑。Fredrika 提交的内容指出了内置转换器存在的问题:在将文本框绑定到 double 字段时,它不会将空字符串转换为 null。为此编写了一个自定义转换器来解决此问题,但其实现并不理想,变量命名不当且逻辑不清晰。该转换器在转换时将值强制转换为 double,在反向转换时强制转换为 string,这可能导致混淆。总体而言,在 WPF 中使用转换器的方法并不受欢迎,而该实现也无助于澄清问题。将空文本框视为 null 值的使用方式也可能在未来引发问题。总之,该转换器 API 及其在此案例中的实现设计不佳,可能导致混淆和潜在问题。 CodeSOD: Convert Back, Way Back thedailywtf.com +1
艰难的告别 叙述者正艰难地应对挚友兼导师阿吉·肖(Aggie Shaw)因突发疾病骤然离世带来的打击。悲痛如潮水般涌来,尽管上司期望其照常工作,叙述者却难以回归日常,于是开始动用带薪休假来处理情绪,努力与失去和解。朋友梅根(Megan)主动联系,提议见面,提供了急需的倾听与慰藉。会面中,叙述者敞开心扉,倾诉内心的感受及对工作的挫败;梅根则建议他们共同创立一个由平等伙伴组成的 IT 团队。这一构想令叙述者深受鼓舞,开始探索各种可能性,包括转为自由职业者与梅根携手开启新事业。在调研与规划的过程中,尽管面临风险与不确定性,叙述者却找到了目标感与兴奋感。叙述者重返工作岗位,只为提交两周的离职通知,着手规划崭新的未来。在阿吉曾经的办公室里,叙述者发现了一只橡皮鸭,这成为阿吉存在的象征,赋予其连接感与继续前行的动力。叙述者决心告别旧职,开启人生新篇章,而梅根将始终相伴。叙述者选择离开,不仅是为了逃离艰难的工作环境,更是为了追寻新的意义与满足。 The Hard Goodbye thedailywtf.com +1
《Error'd》:一首永无止境的歌? 诈骗分子坚持要求用户将内容观看至结尾,这一任务在今天的"Error'd"一集中被幽默地呈现为一种长期承诺。亚马逊近期因向数千名客户发送显著虚高的账单而引发广泛担忧,造成相当大的恐慌。一位名为 Willy 的客户对亚马逊价格的突然上涨表示担忧,并预计将面临财务审查。Dave A. 指出某软件提示的犹豫不决,质疑某项操作是可选还是必须执行。一位匿名用户发现一家屋顶清洁公司在 X 轴和 Y 轴上均显示独特的五星评级系统,幽默地评论道这“超出了屋顶”。Richard H. 收到一封可疑的 QuickBooks 电子邮件,其中引用了一个随机生成的发票编号,强烈暗示这是一起诈骗。B.J. H. 收到了一条异常冗长且令人不安的系统消息,若此类文本被视为“正常”,则引发了对紧急协议的担忧。本集还包含一则关于迁移至 .NET 9 指南的广告,承诺可缓解迁移困难。 Error'd: The Song that Never Ends? thedailywtf.com +1
经典 WTF:我的众多女友” Remy 幽默地建议因天气不悦而退守至一个阴暗、通风不良的洞穴。这种情绪呼应了过往职场中的一种动态:管理者容忍着那些行为怪诞的软件开发者。在 90 年代末,随着 IT 行业的繁荣,管理者已习惯于开发者表现出的非常规行为。在招聘 Sten 时,鉴于其推荐信评价极高,Barry 及其团队便做好了应对其怪诞行为的准备。在入职第一天,Sten 要求一个没有自然光线且可关闭通风设施的办公空间。Barry 发现 Sten 的办公室位于地下室,Sten 正在拆除荧光灯管以进一步昏暗环境。Sten exclusively 使用第三人称指代自己,自称"Sten",且代词使用方式令人困惑。此外,他还大量服用维生素,并饮用一种气味奇特的茶。Sten 的代码风格同样古怪:所有变量和方法均使用女性名字命名,据称这些名字来自他所谓的“女友”。虽然存在一些命名规范,但它们缺乏文档记录,难以解读。代码审查演变为冗长的叙事,使得实际逻辑难以理解。尽管 Sten 行为怪诞且代码风格独特,但其主要败笔在于生产力低下。他无法跟上团队的需求,最终导致被解雇。Barry 随后向另一家公司提供了谨慎的推荐信,建议对方让 Sten 解释其代码。那家公司并未录用 Sten,而 Barry 收到了一份感谢礼品篮。 Classic WTF: My Many Girlfriends thedailywtf.com +1
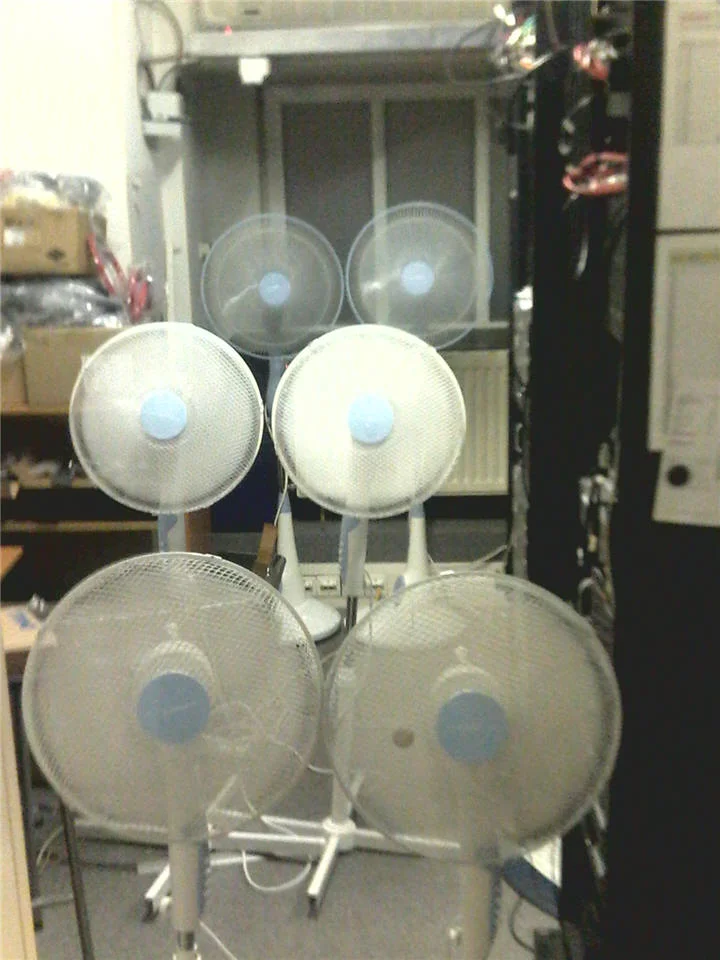
经典 WTF:机房风扇及其他趣事 技术人员在基础设施维护不善和非标准解决方案方面屡遭困扰。一个常见问题源于空调功率不足,导致在服务器机房敞开的门附近出现绊倒隐患。另一位技术人员曾与一台传真机周旋,该设备仅在潮湿天气下间歇性工作,尽管进行了广泛的故障排查和线路测试。问题最终被追溯至一个暴露的电信机楼,其中电缆未受保护,在将照片证据发送给管理层后迅速得到修复。另一令人不安的发现涉及一家软件公司内,一块“异地备份”驱动器被随意放置在木质服务器机柜上。更多临时凑合的解决方案包括采用偏离标准电气规范的非常规布线,宁愿使用裸露连接也不进行正规安装。曼哈顿一家酒店的网络设备被发现悬挂在公共楼梯间的电缆上,完全未固定。在中国,一台交换机被螺栓固定在金属车间数米高的柱子上,凸显了工业环境中更为奇特的安装方式。这些事件凸显了各类环境中 IT 基础设施管理普遍缺乏专业标准。它们表明了一种即兴应对和忽视的模式,而非遵循最佳实践。 Classic WTF: Server Room Fans and More Fun thedailywtf.com +1
CodeSOD:经典 WTF:Fork 和 Log Remy 讲述了一起由 Adam C. 遇到的 VXML 平台性能问题。系统在极低负载下便出现故障,而项目进度已滞后。Adam 对 VXML 并不熟悉,起初通过检查应用程序日志来寻找线索。他反复发现一条错误信息:"Exception encountered writing error log."这条晦涩的消息让 Adam 感到困惑,因为它报告的是日志记录本身出现了错误。深入源代码后,他发现日志实现存在严重缺陷。该代码使用外部命令来记录错误,而非利用现有的日志框架(如 log4j)甚至简单的 System.out.println。Adam 认为这种方法效率低下且设计拙劣。尽管这段代码并非性能问题的根本原因,但它很快被移除。这一轶事凸显了遗留系统中常见的一类技术债务。 CodeSOD: Classic WTF: Fork and Log thedailywtf.com +1
CodeSOD:经典的WTF:桌面选择器 文章在暑假期间回顾了经典代码示例,首先讨论源代码。作者Christian指出,在德语中,“quellcode”直译为“源代码”。他幽默地创造了一个新词“quäl-kot”,将德语脏话和“源代码”结合,用来描述特别恶劣的代码。这个富有感染力的术语灵感来自代码库中遇到的界面设计不良。有问题的界面以C#代码片段的形式呈现。它名为 ITableSelector,包含了大量选择表的方法。具体来说,它有 selectTable1()、selectTable2() 等方法,以及针对 4a/4b、7a/7b、9a/9b、14a/14b/14c/14d 和 21a/21b 等表的多种变体。接口继续列出方法,直到selectTable31()。这份冗长且重复的清单凸显了界面设计上的缺陷。类似方法的数量庞大,表明缺乏抽象或解决方案结构不佳。这种接口暗示了可维护性和扩展性方面可能存在的问题。 CodeSOD: Classic WTF: The Table Selector thedailywtf.com +1
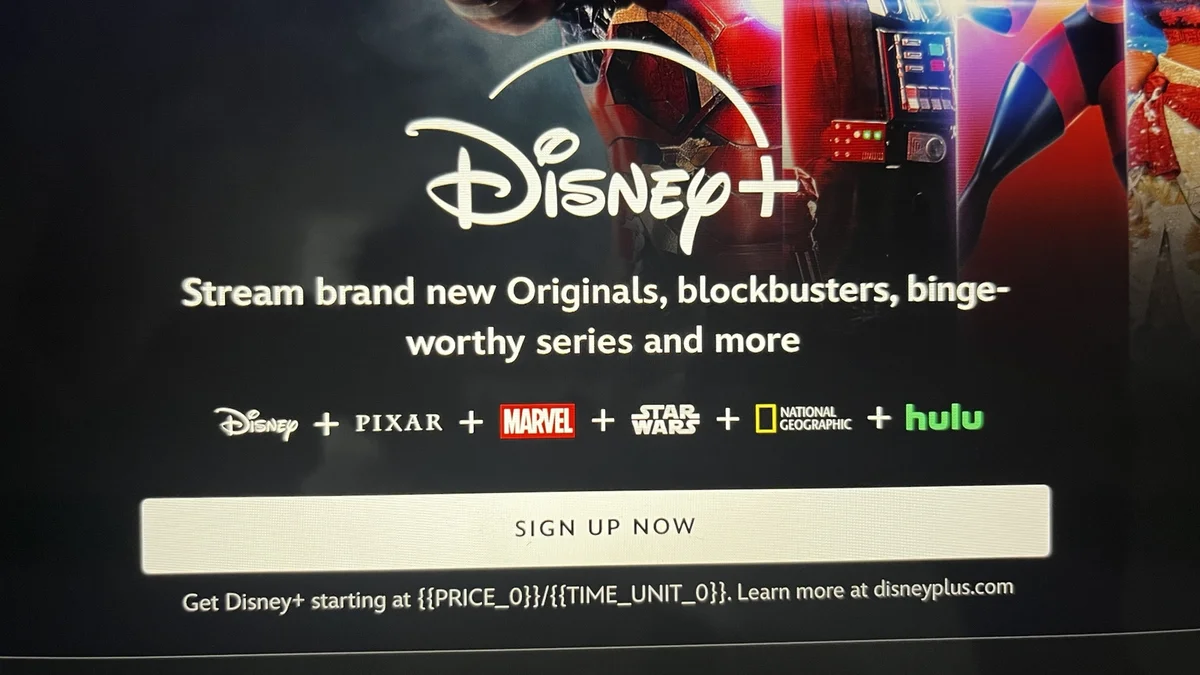
Error'd:公主定价 Sam 推测 Disney+ 可能因错误而测试基于使用量的计费方式,但更常见的解释或许更为合理。一个在线购物网站显示了不合逻辑的定价,对价格为零的商品提供折扣。Harrison 观察到超市某商品标有反向价格变动,原价显示为零,新价则为 99 美元。该折扣被悖论式地描述为负无穷百分比。Dragoncoder047 在其 iPhone 的 Game Center 小部件上遇到了乱码,尽管设备语言设置为英语。Evelyn 报告了一起包裹追踪异常:某商品于七月登记,一月发货,随后又返回至七月。这种时间线不一致并非由简单的时区问题所致。这些案例凸显了各类在线及现实世界中的故障。这些错误涵盖从计费可能性到定价荒谬及显示失误。它们展示了用户所遭遇的意外数字与物流异常。 Error'd: Princess Pricing thedailywtf.com +1
CodeSOD:等待更久” Karen 在规格测试中遇到了不稳定性问题,每运行一千次就会出现几次失败。这些复杂且对时序敏感的测试尽管拥有宽松的超时窗口且单元测试已通过,仍会偶尔失败。问题的根源在于 JavaScript 的 setTimeout:与文档暗示其可能延迟更久不同,在 Node.js 中它实际上可能在指定时间到期之前便调用回调函数。Karen 最初的简单等待函数使用 setTimeout 来引入延迟。经过大量调试后,她发现这种时序不一致是导致测试不稳定的根本原因。为解决此问题,她重写了等待函数,改为每毫秒持续检查已 elapsed 时间。该新函数确保仅在达到目标持续时间后才完成操作,从而防止过早超时。虽然此方案有效,但被认为效率低下,也凸显了功能测试对时序的敏感性问题。此外,它还指出了 Node.js 运行时调度保证的不足。作者对此不得不采用此类变通方案感到沮丧。 CodeSOD: Wait Longer thedailywtf.com +1
CodeSOD:错误检查” 代码库主要由 C 语言编写,函数返回值通常表示状态码。标准惯例是检查布尔返回值是否为真以表示成功。然而,一位资深开发者引入了一种令人困惑的替代惯用法:该开发者检查布尔返回值是否为假以表示错误。由于该开发者的长期任职,这种做法已成为项目内的主流惯例。因此,任何潜在的错误条件都涉及检查名为 'error' 的变量是否等于 FALSE。尽管该惯例在其自身框架内保持一致,但并未正式记录。新开发者最初往往遵循标准模式。然而,大量采用非标准模式的现有代码会对其产生影响。该既定代码库具有强大的惯性,塑造了新代码的风格。现有代码实际上决定了开发风格,而非开发者去改变代码。 CodeSOD: The Error Check thedailywtf.com +1
CodeSOD:AAYFN 提供的 Ruby 代码定义了一个名为 bv 的函数,该函数是 boolean value 的缩写,用于美化打印布尔值并将其转换为字符串。该函数接收四个参数:prop、tv、fv 和 nv,分别表示属性名称、真值、假值和空值。该函数使用 send 方法通过名称访问类的成员,这是一种允许通过字符串进行元编程的 Ruby 惯用法。这种方法可能导致潜在问题,例如对非布尔字段返回"Not Specified",从而产生误导。有观点认为,尝试在非布尔字段上使用该函数应抛出异常。该函数的行为可能令人意外:如果属性不存在,或者被访问的对象是一个需要参数的函数,它将会抛出异常。Ruby 文档建议维护一份允许的布尔值列表,以避免此类问题。然而,通过传递字符串来使用运行时元编程仍可能导致麻烦,并使代码库难以维护。文本作者表达了对这种方法的反感,更倾向于使用 C++ 模板进行元编程,认为其更简单、更清晰。作者认为,非平凡的 Ruby 代码库往往因使用元编程而变得难以维护。总体而言,该代码及其方法被认为存在问题且容易出错。 CodeSOD: AAYFN thedailywtf.com +1